Capítulo 5 Grandes muestras
5.1 Introducción: Aproximaciones asintóticas
En estadística y teoría de la probabilidad, el estudio de las grandes muestras juega un papel crucial debido a su relevancia tanto en la definición frecuentista de probabilidad como en la construcción de estimadores en la práctica estadística.
Desde la perspectiva de la probabilidad frecuentista, la probabilidad se interpreta mediante la estabilización de la frecuencia relativa de un evento al repetir ensayos independientes en las mismas condiciones.
En el contexto de la estadística, las grandes muestras sirven como base para muchas aproximaciones importantes, como las distribuciones de muestreo, las estimaciones de parámetros y la validación de inferencias.
La ley de los grandes números y el teorema central del límite son ejemplos clave de teoremas que se fundamentan en el comportamiento de las muestras grandes, proporcionando las bases para muchos de los métodos estadísticos utilizados en la inferencia moderna.
5.2 Ley de los Grandes Números (Ley débil)
La ley de los grandes números establece que, a medida que el tamaño de la muestra aumenta, la media muestral se aproxima a la media de la población.
Formalmente, la ley de los grandes números en su versión débil se enuncia de la siguiente manera:
Sea \(X_1, X_2, \dots, X_n\) una secuencia de variables aleatorias independientes e idénticamente distribuidas (i.i.d.) con esperanza \(\mu = \mathbb{E}[X_i]\) y varianza \(\sigma^2 = \text{Var}(X_i) < \infty\), entonces para cualquier \(\epsilon > 0\),
\[ \lim_{n \to \infty} P \left( \left| \frac{1}{n} \sum_{i=1}^n X_i - \mu \right| \geq \epsilon \right) = 0. \]
Esto significa que, con alta probabilidad, la media muestral \(\frac{1}{n} \sum_{i=1}^n X_i\) se aproxima a \(\mu\) a medida que \(n\) crece.
Ejemplo 5.2.1. Media de un dado.
Imaginemos un dado equilibrado. Sabemos que la esperanza de cada lanzamiento es el valor promedio de los números en el dado, que es
\[ \mu = \frac{1+2+3+4+5+6}{6} = 3.5. \]
Ahora, supongamos que lanzamos el dado repetidamente y calculamos la media de los resultados. Al principio, con pocos lanzamientos, la media puede estar alejada de 3.5, pero a medida que aumentan los lanzamientos, la media tenderá a estabilizarse alrededor de 3.5, aunque no tiene por qué acercarse en cada nuevo lanzamiento, como lo predice la ley de los grandes números. Es decir, a medida que lanzamos más veces el dado, la probabilidad de que la media de los resultados se aleje de 3.5 por más de una cantidad arbitraria disminuye.
Podemos ilustrarlo con el siguiente código de R
set.seed(20261110)
max_n <- 10000
lanzamientos <- sample(1:6, max_n, replace = TRUE)
medias <- cumsum(lanzamientos) / seq_len(max_n)
plot(seq_len(max_n), medias, type = "l", col = "blue",
     xlab = "Número de lanzamientos (n)", ylab = "Media acumulada")
abline(h = 3.5, col = "red", lwd = 2, lty = 2)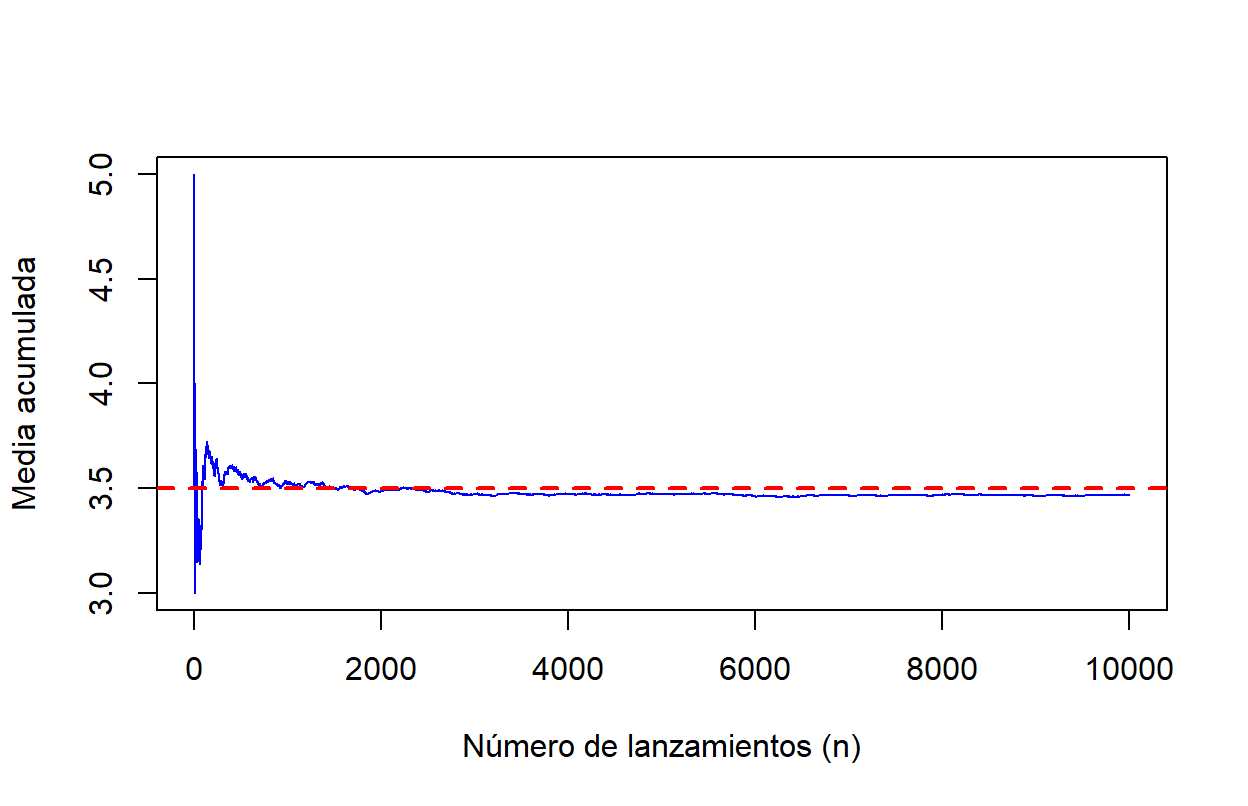
Figure 5.1: Medias acumuladas de una secuencia de lanzamientos independientes de un dado equilibrado.
Este comportamiento es una manifestación intuitiva de la ley débil de los grandes números, aunque una sola trayectoria no demuestra el teorema: la ley débil afirma que la probabilidad de una desviación fija tiende a cero. No exige una aproximación monótona ni que cada trayectoria permanezca siempre dentro de una banda dada.
5.3 El teorema central del límite
El teorema central del límite (a partir de ahora, TCL) presenta un doble interés. Por un lado, proporciona a la estadística un resultado crucial para abordar el estudio de la distribución asintótica de muchos tipos de variables aleatorias. Como se verá en próximos capítulos, va a resultar básico en la construcción de contrastes de hipótesis y de intervalos de confianza, dos herramientas esenciales en estadística aplicada.
Además, el TCL proporciona una explicación teórica fundamentada a un fenómeno habitual en experimentos reales: las variables estudiadas presentan muchas veces una distribución empírica aproximadamente normal.
El TCL forma parte de un conjunto de propiedades relativas a las convergencias de variables aleatorias. Tras la ley débil, que expresa una convergencia en probabilidad, introducimos la convergencia en ley necesaria para enunciar el TCL. No desarrollamos aquí otros tipos de convergencia, como la convergencia casi segura.
Posiblemente el lector con poca formación en análisis matemático hallará alguna dificultad en la primera lectura de la definición de convergencia en ley y en el enunciado del TCL. Si es este el caso, los ejemplos incluidos han de ayudar en su comprensión. Consideramos al TCL un resultado básico con el que hay que familiarizarse, ya que se aplicará repetidamente en los próximos temas.
5.3.1 Sumas de variables aleatorias
El TCL estudia el comportamiento de las sumas de variables aleatorias. En temas anteriores se han visto ya ejemplos de sumas de variables aleatorias.
Formalmente, la suma de dos variables aleatorias corresponde a la siguiente aplicación: si \(X_{1}\) y \(X_{2}\) son dos variables aleatorias definidas sobre \(\Omega\), la suma es:
\[ \begin{aligned} X_{1}+X_{2}: & \Omega \rightarrow \mathbb{R} \\ & \omega \mapsto X_{1}(\omega)+X_{2}(\omega) \end{aligned} \]
La suma de dos variables puede extenderse sin dificultad a sumas de tres, cuatro,… y, en general, \(n\) variables aleatorias.
El TCL se ocupa de las sucesiones de variables aleatorias. En el contexto del TCL una sucesión corresponde a un conjunto donde el primer elemento es una variable aleatoria, el segundo elemento es la suma de dos variables aleatorias, el tercero es la suma de tres variables aleatorias, y así sucesivamente.
Una sucesión es una familia ordenada de elementos indexados por los números naturales, que se designan simbólicamente mediante \(\left\{X_{n}\right\}\). Cada uno de los elementos de la sucesión (que es una variable aleatoria) lleva asociada una determinada función de distribución:
\[ X_{n} \rightarrow F_{n} \]
Así pues, la sucesión de variables aleatorias lleva asociada una secuencia paralela de funciones de distribución.
5.3.2 Definición de convergencia en ley
La siguiente definición se ocupa del comportamiento de las sucesiones. Sea \(\left\{X_{n}\right\}\) una sucesión de variables aleatorias, y sea \(\left\{F_{n}\right\}\) la correspondiente sucesión de funciones de distribución. Se dice que \(\left\{X_{n}\right\}\) converge en ley a una variable aleatoria \(X\) de función de distribución \(F\) si:
\[ \lim _{n \rightarrow \infty} F_{n}(x)=F(x) \quad \text { para todo } \mathrm{x} \text { donde } F \text { es continua. } \]
Se indica que la sucesión converge en ley mediante el símbolo:
\[ X_{n} \stackrel{\mathrm{L}}{\rightarrow} X \]
El significado de la definición es que, al aumentar arbitrariamente \(n\), las sucesivas funciones de distribución de la secuencia se aproximan a la distribución \(F\) de la variable \(X\).
En los ejemplos se presentan gráficamente algunas situaciones donde diferentes sucesiones de variables aleatorias convergen en ley a una variable aleatoria normal.
5.3.3 Enunciado del teorema central del límite
A continuación se presenta el enunciado del TCL en la versión de Lindeberg y Lévy. Teorema: Sea \(X_{1}, X_{2}, \ldots, X_{n}\), un conjunto de variables aleatorias independientes idénticamente distribuidas, cada una de ellas con función de distribución \(F\), y supongamos que \(E\left(X_{k}\right)\) \(=\mu \mathrm{y} \operatorname{var}\left(X_{k}\right)=\sigma^{2}\), con \(0<\sigma^2<\infty\), para cualquier elemento de la sucesión. Si designamos a la suma normalizada de \(n\) términos con el símbolo:
\[ S_{n}^{*}=\frac{X_{1}+X_{2}+\cdots+X_{n}-n \mu}{\sigma \sqrt{n}} \]
entonces la sucesión de sumas normalizadas converge en ley a la variable aleatoria normal tipificada \(\mathrm{Z} \sim N(0,1)\), es decir:
\[ S_{n}^{*} \xrightarrow{\mathrm{L}} Z \sim N(0,1). \]
El teorema anterior permite obtener dos aproximaciones para \(n\) suficientemente grande (el segundo parámetro de \(N\) es la varianza):
Si consideramos la suma ordinaria de las \(n\) variables aleatorias, es decir, \(S_{n}=X_{1}+X_{2}+\ldots+X_{n}\), podemos aproximar su distribución por \(N(n\mu,n\sigma^2)\).
Si consideramos el promedio de las \(n\) variables aleatorias, es decir, \(n^{-1} S_{n}\), podemos aproximar su distribución por \(N(\mu,\sigma^2/n)\).
Estas normales dependen de \(n\): son aproximaciones, no distribuciones límite fijas. La convergencia en ley del TCL se refiere a la suma tipificada; la media sin tipificar converge en probabilidad a la constante \(\mu\).
5.3.3.1 Comentarios al teorema:
- La convergencia a la normal tipificada se produce con cualquier tipo de variable que cumpla las condiciones del teorema, sea discreta o absolutamente continua.
- Un sinónimo para indicar que una sucesión converge en ley a una normal es señalar que es asintóticamente normal.
- El TCL describe el límite de una sucesión de sumas finitas tipificadas cuando aumenta el número de sumandos. Veremos posteriormente como interpretar el resultado para valores finitos.
- Existen otras versiones del TCL dónde se relajan las condiciones de la versión de Lindeberg y Lévy, que, como se ha visto, exige independencia y una distribución común con varianza positiva y finita. Dichas versiones del TCL necesitan el conocimiento de conceptos matemáticos que exceden el nivel al que se orienta Statmedia, y por esta razón se omite su enunciado.
5.3.4 Algunos ejemplos de aplicación del TCL
Ejemplo 5.3.1. Normalidad asintótica de la Binomial.
set.seed(20261111)
# Parámetros de la distribución binomial
n <- 1000  # Número de ensayos
p <- 0.5   # Probabilidad de éxito
size <- 10000  # Número de simulaciones

# Generar una variable aleatoria binomial
binomial_sample <- rbinom(size, n, p)

# Estimación de la media y la desviación estándar de la distribución binomial
mean_binom <- n * p
sd_binom <- sqrt(n * p * (1 - p))

# Generar la distribución normal aproximada
normal_sample <- rnorm(size, mean = mean_binom, sd = sd_binom)

# Graficar los histogramas de la binomial y la normal
u5_par <- par(mfrow = c(1, 2))  # Organizar gráficos en dos paneles

# Histograma de la muestra binomial
hist(binomial_sample, breaks = 50, probability = TRUE,
     col = rgb(0, 0, 1, 0.5), xlim = mean_binom + c(-4, 4) * sd_binom,
     main = "Distribución Binomial", xlab = "Valor",
     ylab = "Densidad")
lines(density(binomial_sample), col = "blue", lwd = 2)

# Histograma de la distribución normal aproximada
hist(normal_sample, breaks = 50, probability = TRUE,
     col = rgb(1, 0, 0, 0.5), xlim = mean_binom + c(-4, 4) * sd_binom,
     main = "Distribución Normal Aproximada", xlab = "Valor",
     ylab = "Densidad")
lines(density(normal_sample), col = "red", lwd = 2)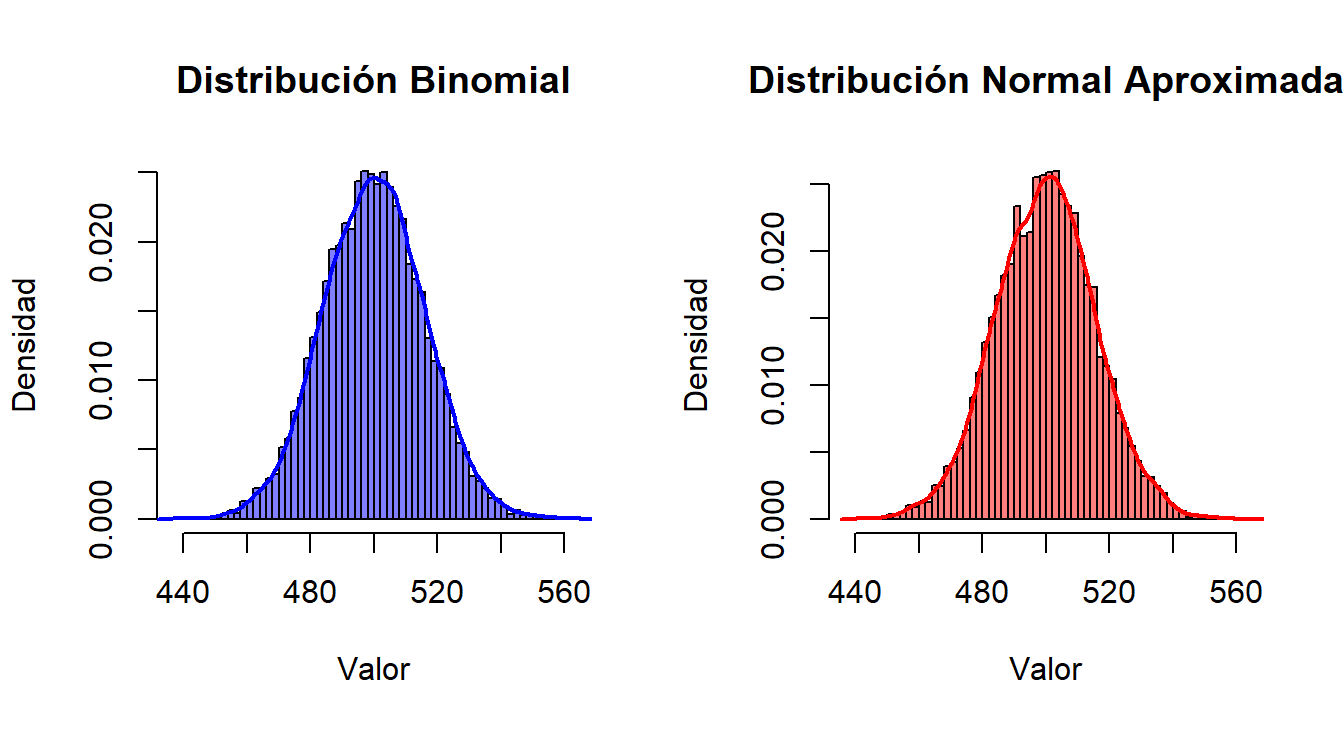
Figure 5.2: Comparación simulada de una binomial y su aproximación normal.
par(u5_par)Ejemplo 5.3.2. Normalidad asintótica de la suma de puntuaciones de un dado.
set.seed(20261112)
# Parámetros de la simulación
num_simulaciones <- 10000  # Número de simulaciones
num_lanzamientos <- c(10, 100, 1000, 10000)  # Diferentes tamaños de muestra

# Función para simular la suma de las puntuaciones de un dado
simular_suma_dado <- function(n) {
  # Cada fila contiene los recuentos de las seis caras en n lanzamientos.
  # Evitamos almacenar n * num_simulaciones lanzamientos individuales.
  recuentos <- rmultinom(num_simulaciones, size = n, prob = rep(1/6, 6))
  suma <- as.vector(crossprod(1:6, recuentos))
  return(suma)
}

# Graficar las distribuciones de las sumas para diferentes tamaños de muestra
u5_par <- par(mfrow = c(2, 2))  # Organizar gráficos en 2x2

for (n in num_lanzamientos) {
  suma_dado <- simular_suma_dado(n)
  # Histograma de la suma de las puntuaciones del dado
  hist(suma_dado, breaks = 50, probability = TRUE,
       col = rgb(0, 0, 1, 0.5), xlim = c(min(suma_dado), max(suma_dado)),
       main = paste("Suma de", n, "dados"),
       xlab = "Suma de puntuaciones", ylab = "Densidad")
  # Superponer la curva de densidad normal (aproximación asintótica)
  mean_dado <- 3.5 * n  # Media esperada de la suma (media de un dado es 3.5)
  sd_dado <- sqrt(n * (35 / 12))  # Desviación estándar de la suma (varianza de un dado es 35/12)
  curve(dnorm(x, mean = mean_dado, sd = sd_dado),
        col = "red", lwd = 2, add = TRUE)
}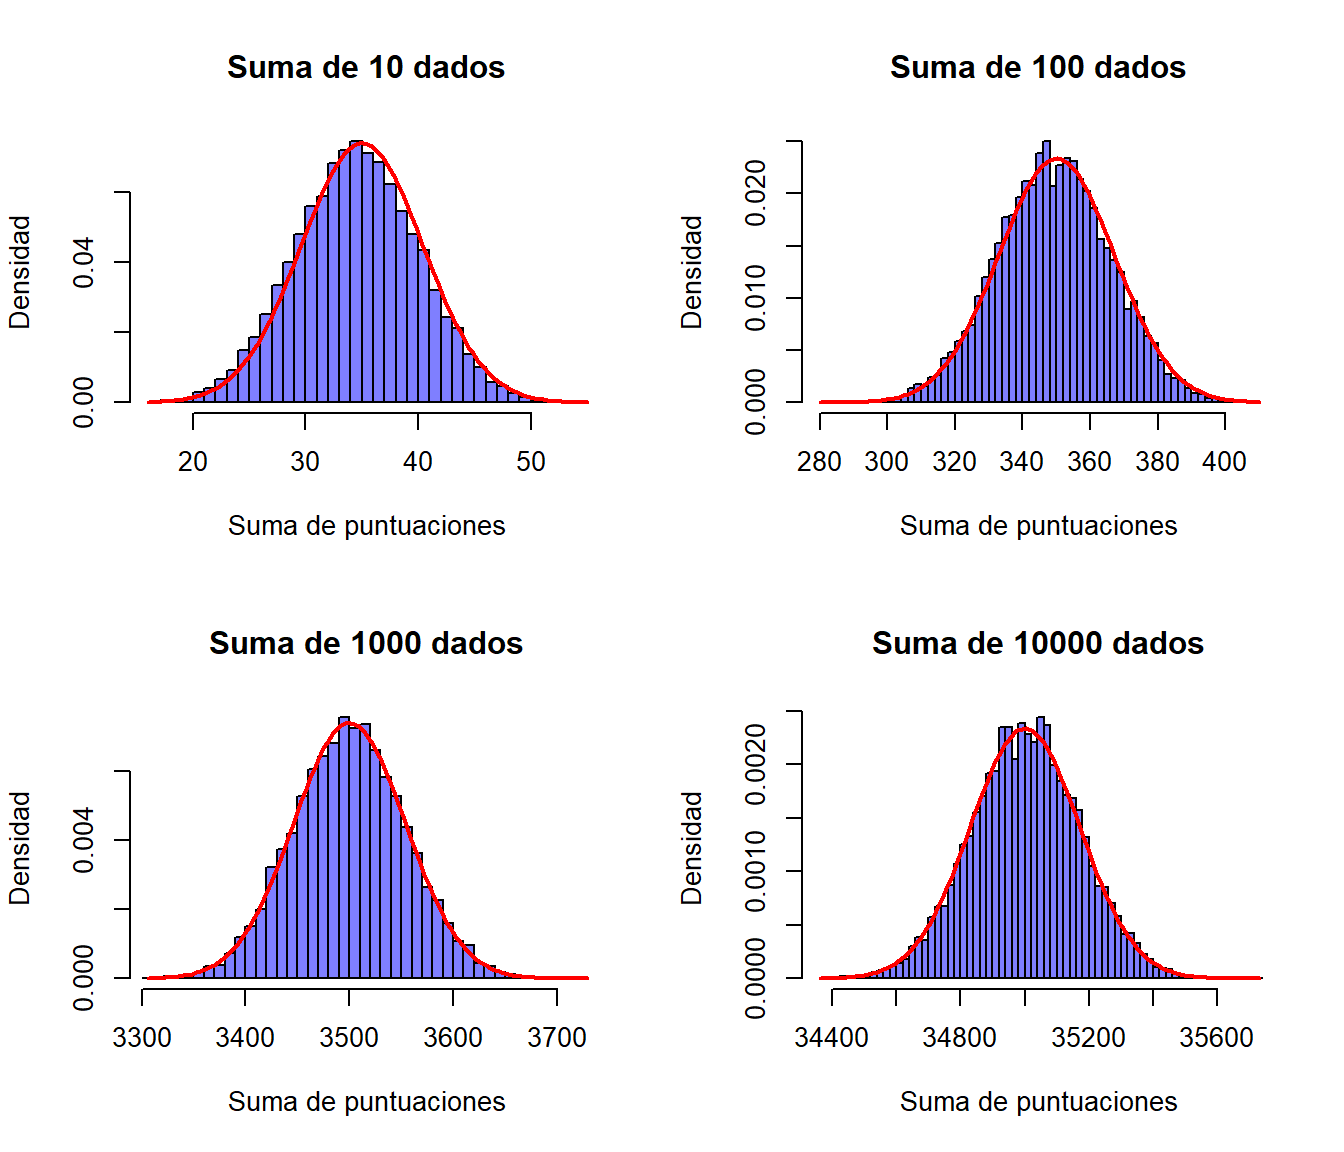
Figure 5.3: Sumas de puntuaciones de un dado y densidades normales con la misma media y varianza.
par(u5_par)5.3.5 Casos particulares más notables
Aunque el TCL tiene multitud de casos particulares interesantes, son especialmente relevantes para el desarrollo de los próximos temas los siguientes casos:
5.3.5.1 Promedio de \(\boldsymbol{n}\) variables aleatorias
Al considerar \(n\) variables independientes, todas con la misma distribución, cada una de ellas con esperanza igual a \(\mu\) y varianza igual a \(\sigma^{2}\), el promedio es asintóticamente normal con media \(\mu\) y varianza \(n^{-1} \sigma^{2}\). Este resultado proporciona una distribución asintótica a la media de \(n\) observaciones en el muestreo aleatorio simple que se estudiará en el próximo tema.
5.3.6 Interpretación del teorema central del límite
El TCL establece que las funciones de distribución de las sumas tipificadas convergen a la función de distribución normal estándar. Para un número finito de sumandos, la aproximación puede tener un error apreciable, especialmente en las colas.
Sin embargo, puede utilizarse esta distribución final de referencia para aproximar distribuciones correspondientes a sumas finitas. Algunos casos particulares importantes (binomial, Poisson, etc.) alcanzan grados de aproximación suficientes para sumas con no demasiados términos.
Los resultados que se indican a continuación son, por tanto, aproximaciones que se consideran usualmente suficientes, pero conllevan errores numéricos de aproximación.
Binomial: puede aproximarse por una normal de media \(np\) y varianza \(np(1-p)\) cuando ambos recuentos esperados, \(np\) y \(n(1-p)\), son suficientemente grandes. Usar ambos mayores o iguales que 10 es una orientación, no una garantía de precisión. Para \(P(X\leq k)\) se utiliza la corrección de continuidad \(P(Y\leq k+0.5)\); conviene comparar con
pbinomcuando interese precisión.Poisson: para \(\lambda\) grande puede aproximarse por una normal de media y varianza \(\lambda\), aplicando también corrección de continuidad. El valor \(\lambda=10\) es solo una orientación inicial: la calidad depende de la probabilidad que se calcule y puede comprobarse con
ppois.
Desde este enlace puede accederse a un repositorio de github desde donde descargar una aplicación Shiny que permite ilustrar el teorema central del límite para distintas distribuciones, con muestras de distinto tamaño y parámetros de valores distintos.
Un poco de práctica con la aplicación permite ver que a la larga si el tamaño muestral es lo suficientemente grande, la suma o la media de los valores se distribuye claramente como una distribución normal.
Esto, además, va a depender del valor de los parámetros. Así por ejemplo, para aproximar una distribución de Poisson de parámetro \(\lambda=1\) por una normal, necesitaríamos un tamaño muestral mayor que si, con el mismo tamaño, tenemos una ley de Poisson de parámetro \(\lambda=10\).
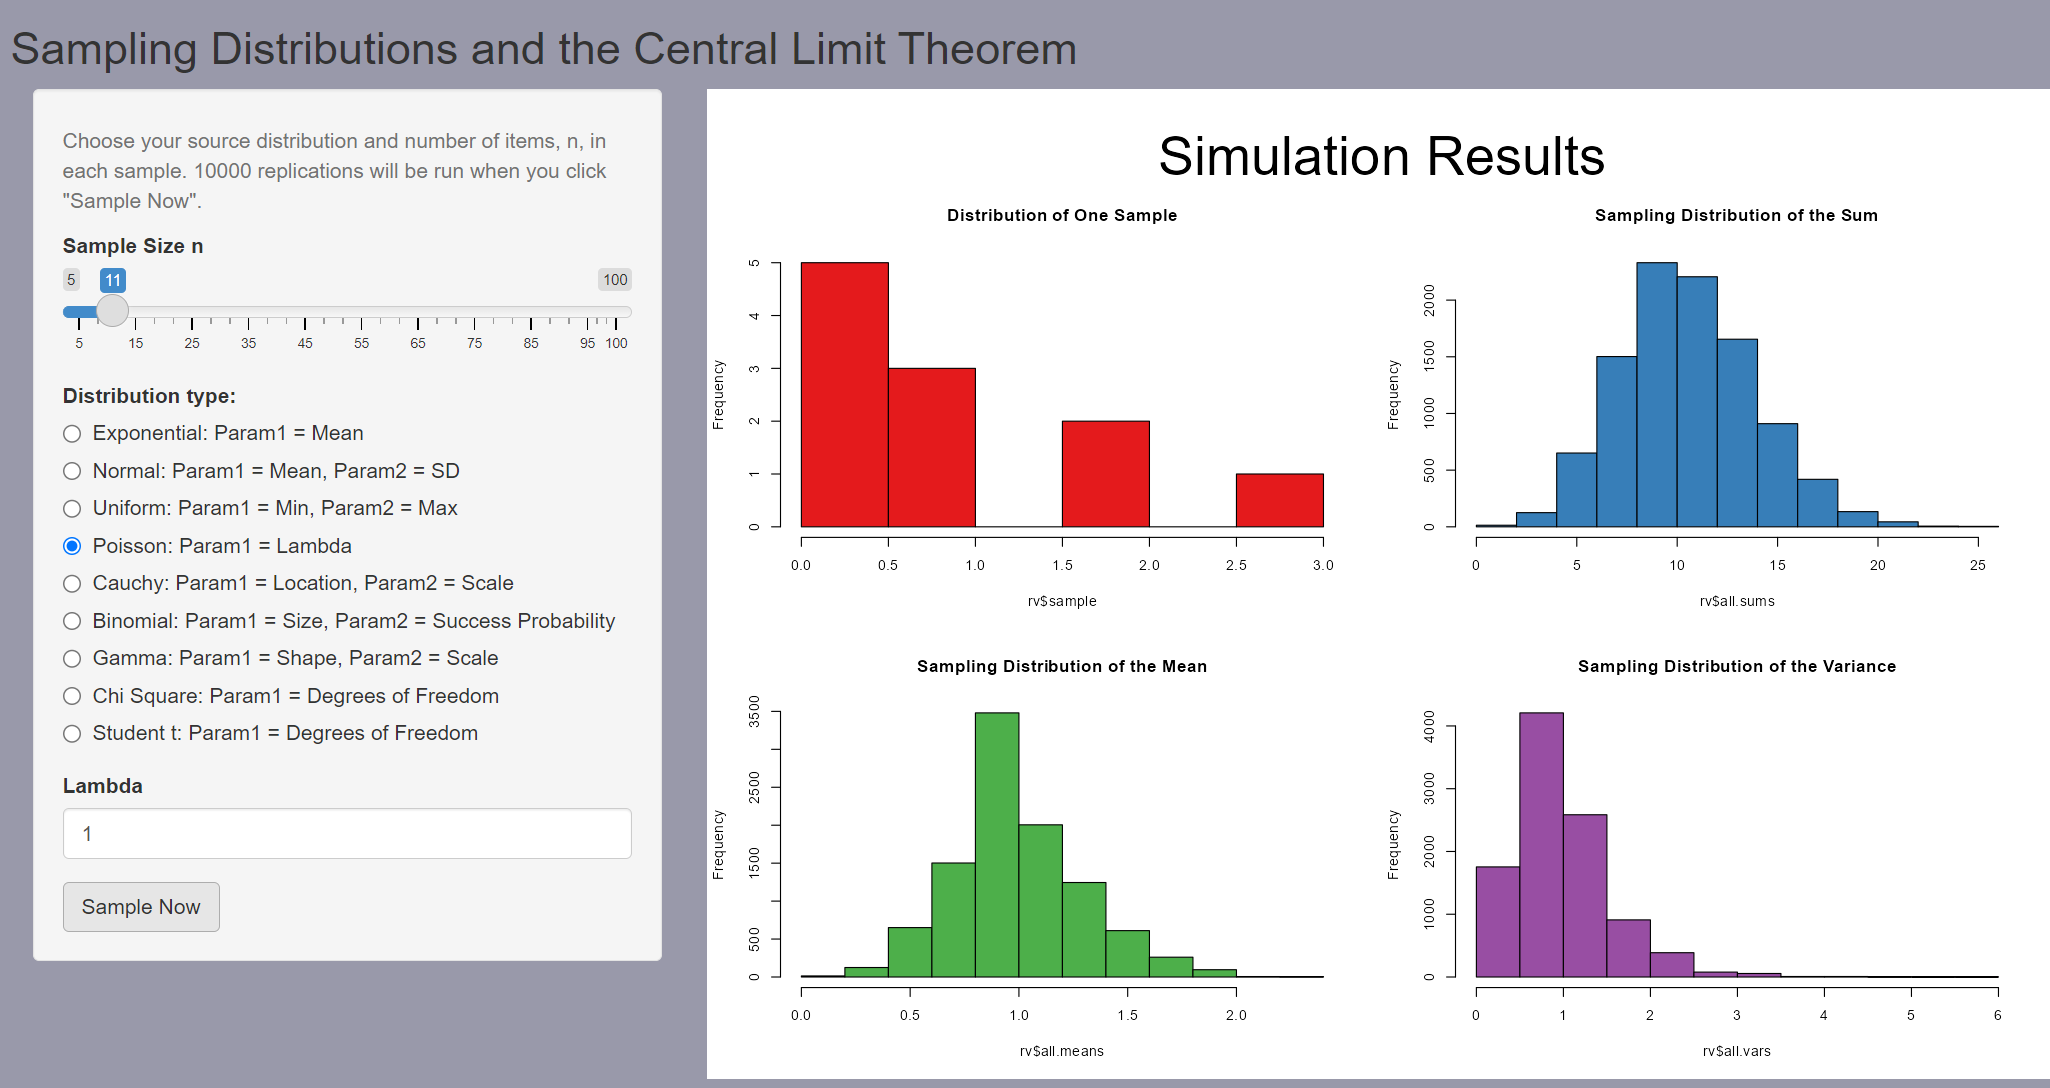
Una distribución Poisson de parámetro 11 puede representarse como la suma de 11 variables Poisson independientes de parámetro 1. Por ello, aunque cada sumando sea asimétrico, la suma puede tener una forma más próxima a la normal. Con 11 sumandos la aproximación todavía es imperfecta: no afirmamos normalidad exacta ni garantizamos precisión en las colas.
5.3.7 Acerca de las variables aproximadamente normales
En general, cuando se estudia en experimentos reales una determinada variable no se conoce su distribución teórica. Sin embargo, puede establecerse su distribución empírica a partir de una muestra más o menos amplia.
Una forma habitual de presentar la distribución empírica es construir el histograma de clases de dicha variable. Es un hecho conocido desde el siglo XIX que esta distribución empírica presenta muchas veces una forma que es aproximadamente normal. El histograma siguiente se conserva de los materiales docentes de Statmedia, donde se presenta como un ejemplo del peso de varones de dieciocho años en Cataluña. Esos materiales no indican la fuente primaria de los datos. Aquí se utiliza únicamente para ilustrar una distribución de forma aproximadamente normal:
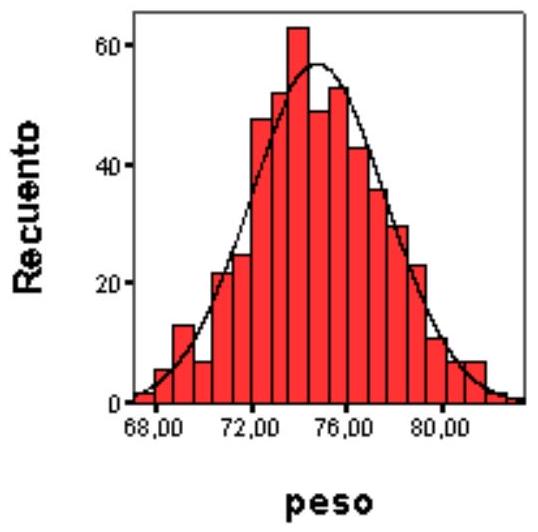
El TCL permite dar una explicación a este fenómeno. La variable peso de un adulto viene determinada en cada individuo por la conjunción de multitud de diferentes factores. Algunos de estos factores son ambientales (dietas, ejercicio, enfermedades, etc.) y otros son congénitos. Con el nivel actual de conocimiento no se pueden desglosar completamente todos los factores que intervienen, pero puede aceptarse en cambio que la variable peso es el resultante de la suma de diferentes variables primarias, congénitas o ambientales, y que posiblemente no todas tienen el mismo grado de influencia. Seguramente, estas variables primarias tampoco tienen la misma media, varianza o, incluso, la misma distribución.
La versión del TCL que se ha presentado aquí exige estas condiciones para la convergencia a la normal, pero, como ya se ha comentado antes otras versiones más elaboradas del TCL permiten modelar la suma de variables de forma menos restringida. En este contexto, al considerar la variable peso como una suma más o menos extensa (pero finita) de diferentes variables primarias, puede resultar plausible una aproximación normal si se cumplen condiciones adecuadas sobre la dependencia y la influencia de cada factor. La suma de muchos factores por sí sola no garantiza normalidad.
De forma similar es explicable la normalidad aproximada que se observa en muchas variables biométricas (pesos, alturas, longitudes, concentraciones de metabolitos, etc.) así cómo en muchos otros contextos (errores de medición, etc.; las rentas, por ejemplo, suelen presentar fuerte asimetría). A pesar de esta ubicuidad de la distribución normal, el lector no debe inferir que es forzosamente, ni mucho menos, la distribución de referencia en todo estudio aplicado.